Extrair URLs de um sitemap para CSV ou JSON: 5 métodos

Para extrair URLs de um sitemap, basta o texto dos elementos loc. O problema é o namespace XML: uma consulta //loc simples não encontra nada. Aqui estão cinco jeitos de tirar essa lista em CSV, JSON ou texto simples, de uma ferramenta no navegador sem configuração até um script em Python que também segue um índice de sitemaps.
Por que //loc não retorna nada em um sitemap?
Todo sitemap declara um namespace no elemento raiz: <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">. O protocolo sitemaps.org exige isso. Como é um namespace padrão, sem prefixo, todos os elementos <url> e <loc> do arquivo pertencem a ele.
O XPath 1.0 trata um nome sem prefixo como um nome sem namespace. Assim, //loc procura um elemento <loc> que não tenha namespace, e um sitemap válido não tem nenhum. A consulta é XPath correto. Ela só encontra zero nós, e é por isso que tantos scripts e fórmulas devolvem um resultado vazio.
Há duas soluções, e cada método abaixo usa uma delas:
- Encontrar o elemento só pelo nome local:
//*[local-name()='loc']. Funciona em qualquer ferramenta XPath 1.0, sem configuração. - Associar um prefixo ao URI do namespace e usá-lo:
//sm:loc, em quesmrepresentahttp://www.sitemaps.org/schemas/sitemap/0.9. O Python e a maioria das bibliotecas permitem isso.
Você pode testar as duas no seu próprio arquivo com o nosso testador de XPath online. Ele dá ao namespace padrão o prefixo d, então //d:loc lista cada URL com a sua linha.
Mais uma armadilha: o índice de sitemaps. A raiz dele é <sitemapindex>, e os elementos <loc> apontam para outros sitemaps, não para páginas. O Google aceita até 50.000 deles por índice, todos do mesmo site, a menos que o envio entre sites esteja configurado. O WordPress serve um por padrão, como mostra o nosso guia sobre os endereços do sitemap do WordPress. Cada método abaixo diz como lida com um índice.
Sitemap para CSV no navegador, sem instalar nada
O nosso verificador de sitemap gratuito lê um sitemap que você cola, abre ou solta na página, em .xml ou .xml.gz. O arquivo fica no seu navegador. Depois da verificação, a aba «URLs» mostra uma tabela com quatro colunas: URL, última modificação, frequência de alteração e prioridade.
- Abra o sitemap no navegador e salve o arquivo, ou copie o código-fonte.
- Cole o conteúdo no verificador de sitemap, ou use «Abrir arquivo…», e clique em «Verificar sitemap».
- Abra a aba «URLs». Digite parte de um endereço em «Filtrar URLs» para manter só algumas linhas, e clique no cabeçalho de uma coluna para ordenar.
- Clique em «Exportar CSV».
O CSV traz as linhas como a tabela as mostra, com filtro e ordenação, nas colunas loc, lastmod, changefreq e priority. Ele é gravado em UTF-8 com marca de ordem de bytes (BOM), então o Excel mostra os caracteres acentuados corretamente. Uma célula que começa com =, +, - ou @ recebe um apóstrofo na frente, para que a planilha não a execute como fórmula. O arquivo recebe o nome do arquivo que você abriu, ou sitemap.csv no caso de um texto colado.
Dois limites. A ferramenta exporta só CSV, não JSON. E ela nunca se conecta a outros sites, então não consegue ler um sitemap pelo URL nem seguir os sitemaps listados em um índice. Em um índice, a aba se chama «Sitemaps» e o CSV tem duas colunas, loc e lastmod: os sitemaps filhos, não as páginas.
Para obter JSON a partir de um arquivo, o conversor de XML para JSON converte o sitemap inteiro. Você recebe a estrutura dele, com cada <url> como um objeto, e não uma lista simples de linhas.
Exportar um sitemap publicado no Chrome em CSV ou JSON
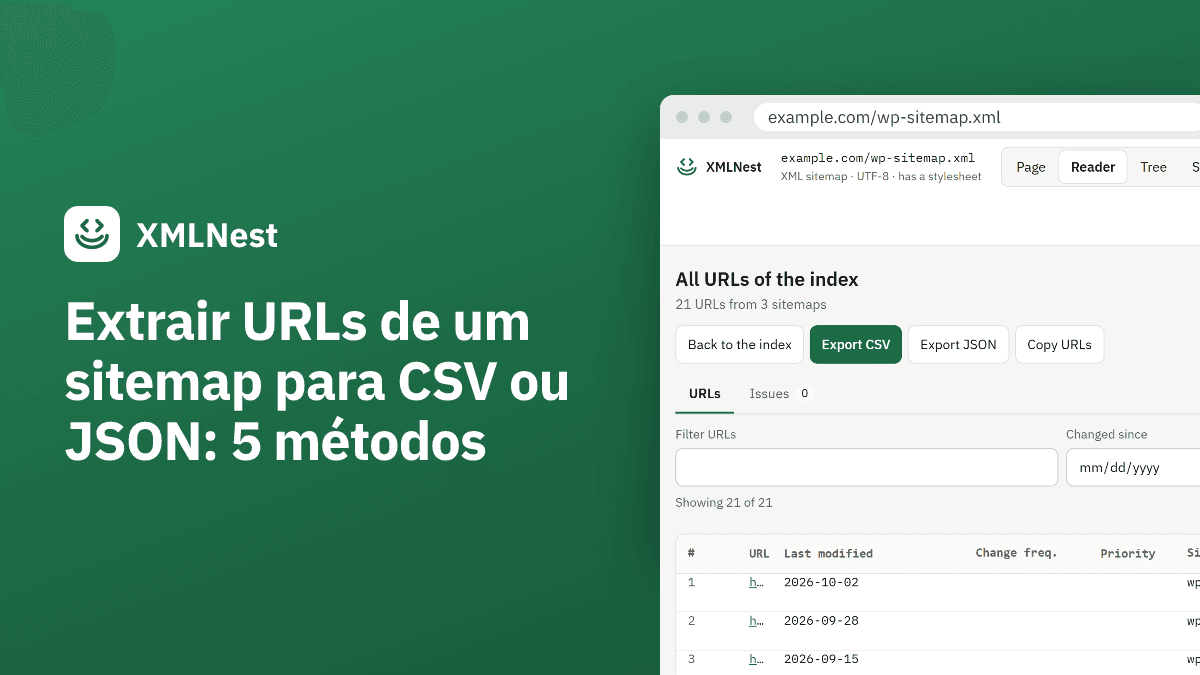
A extensão XMLNest para Chrome, disponível na Chrome Web Store, abre no Chrome o URL de um sitemap publicado e o mostra como tabela na visualização «Leitor». Acima da tabela há três botões:
- Exportar CSV salva as colunas de URL, data de modificação, frequência de alteração e prioridade, mais a contagem de imagens e de versões alternativas quando o sitemap tem entradas de imagem ou hreflang.
- Exportar JSON salva uma lista de objetos com as chaves
loc,lastmod,changefreq,priority,imagesealternates. - Copiar URLs copia só os endereços, um por linha, prontos para colar em uma coluna ou em um rastreador.
Os três usam as linhas exibidas, na ordem exibida. «Filtrar URLs» mantém os endereços que contêm um texto, e «Alterado desde» mantém os URLs modificados nessa data ou depois dela. Filtre /blog/ e escolha uma data: você exporta só os artigos recentes. Como no verificador de sitemap, as células do CSV que começam com =, +, - ou @ são escapadas.
Em um índice, «Carregar todos os sitemaps filhos» lê os sitemaps do mesmo site listados nele, no máximo 50, um de cada vez. A extensão nunca solicita sitemaps de outros sites. Depois, «Mostrar todas as URLs» junta todos em uma única tabela, com uma coluna «Sitemap» a mais que indica o arquivo de origem de cada URL, e as três exportações também funcionam nessa tabela.
Extrair os URLs com curl e xmllint
O xmllint faz parte da libxml2. O macOS já vem com ele, o Debian e o Ubuntu o oferecem no pacote libxml2-utils, e no Windows você pode usá-lo pelo WSL. A opção --xpath executa uma expressão e imprime o resultado:
curl -s https://www.example.com/sitemap.xml \
  | xmllint --xpath "//*[local-name()='loc']/text()" - > urls.txt
O - diz ao xmllint para ler da saída do comando anterior (o pipe). Com //loc no lugar, o manual diz que o xmllint imprime “XPath set is empty” e sai com o código 11: é o problema de namespace descrito acima. O manual não documenta nenhuma opção para associar um prefixo de namespace no --xpath, por isso a forma com local-name() é a mais prática aqui.
O manual só diz que cada nó do resultado é serializado por inteiro. Confira se a sua versão imprime um URL por linha antes de passar urls.txt para outro script.
Um sitemap compactado com gzip precisa de mais uma etapa, gunzip, entre o download e o xmllint:
curl -s https://www.example.com/sitemap.xml.gz | gunzip \
  | xmllint --xpath "//*[local-name()='loc']/text()" -
Em um índice, o mesmo comando retorna os endereços dos sitemaps filhos. Execute-o de novo em cada um deles para obter as páginas:
curl -s https://www.example.com/sitemap_index.xml \
  | xmllint --xpath "//*[local-name()='loc']/text()" - \
  | while read -r sm; do
      curl -s "$sm" | xmllint --xpath "//*[local-name()='loc']/text()" -
    done > all-urls.txt
Executamos o exemplo em Python abaixo; os comandos do xmllint seguem o manual.
Python: sitemap para JSON ou CSV, com índices
O ElementTree do Python expande o namespace padrão no nome da tag, então a raiz de um sitemap vira {http://www.sitemaps.org/schemas/sitemap/0.9}urlset. No nosso teste com o Python 3.14, root.findall(".//loc") retornou zero elementos. A documentação do Python mostra a solução: passar um dicionário de prefixos para find() e findall().
Este script lê um sitemap ou um índice pelo URL, segue os sitemaps filhos de um índice, descompacta arquivos gzip e grava loc, lastmod e o sitemap de origem em urls.csv:
import csv
import gzip
import sys
import urllib.request
import xml.etree.ElementTree as ET

NS = {"sm": "http://www.sitemaps.org/schemas/sitemap/0.9"}

def read(url):
    with urllib.request.urlopen(url) as response:
        data = response.read()
    if data[:2] == b"\x1f\x8b":  # gzip
        data = gzip.decompress(data)
    return ET.fromstring(data)

def collect(url, rows):
    root = read(url)
    if root.tag == "{%s}sitemapindex" % NS["sm"]:
        for child in root.findall("sm:sitemap/sm:loc", NS):
            collect(child.text.strip(), rows)
    else:
        for entry in root.findall("sm:url", NS):
            rows.append([entry.findtext("sm:loc", "", NS).strip(),
                         entry.findtext("sm:lastmod", "", NS).strip(),
                         url])

rows = []
collect(sys.argv[1], rows)
with open("urls.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["loc", "lastmod", "sitemap"])
    writer.writerows(rows)
print(len(rows), "URLs written to urls.csv")
Execute com python sitemap_to_csv.py https://www.example.com/sitemap_index.xml. No nosso índice de teste, que listava um sitemap simples e um .xml.gz, ele gravou quatro linhas. Um URL escrito ?page=2&sort=new no XML saiu como ?page=2&sort=new, porque o parser decodifica as entidades.
Para JSON, troque o último bloco por json.dump(), da biblioteca padrão, por exemplo com uma lista de objetos com as chaves loc, lastmod e sitemap. Se você analisa sitemaps de sites que não controla, leia antes a seção sobre segurança de XML na documentação do Python.
Google Sheets e IMPORTXML: uma lista de URLs em uma coluna
A página de ajuda do Google sobre IMPORTXML inclui o XML entre os tipos de dados que a função lê. A sintaxe é IMPORTXML(url, xpath_query, locale), e o URL pode ser uma referência de célula. Use a forma com local-name() em uma célula:
=IMPORTXML("https://www.example.com/sitemap.xml", "//*[local-name()='loc']")
A página de ajuda não fala de namespaces XML. A expressão local-name() não depende de como o Sheets os trata, porque encontra o elemento só pelo nome. Depois, «Arquivo > Fazer download > Valores separados por vírgula (.csv)» salva a planilha como arquivo CSV. Não testamos o IMPORTXML para este artigo; esta seção segue a página de ajuda do Google.
Em um índice, a fórmula retorna os sitemaps filhos. Coloque o endereço de um filho por célula na coluna A e use =IMPORTXML(A2, "//*[local-name()='loc']") na coluna seguinte para cada um deles.
Se o próprio sitemap não carregar, comece pelo nosso artigo sobre o status «Não foi possível buscar»: uma página de erro em HTML não tem nenhum elemento <loc>.
Fontes
- sitemaps.org: Protocolo (consultada em 29 de outubro de 2026)
- Google Search Central: Gerenciar sitemaps com arquivos de índice (consultada em 29 de outubro de 2026)
- W3C: XML Path Language (XPath) 1.0, testes de nó (consultada em 29 de outubro de 2026)
- libxml2: página de manual do xmllint (consultada em 29 de outubro de 2026)
- Documentação do Python: xml.etree.ElementTree, análise de XML com namespaces (consultada em 29 de outubro de 2026)
- Documentação do Python: segurança de XML (consultada em 29 de outubro de 2026)
- IMPORTXML - Ajuda do Editores de arquivos Google (consultada em 29 de outubro de 2026)
- Teste do XMLNest : Testado pelo XMLNest em 29 de outubro de 2026 com o Python 3.14.3: findall('.//loc') do ElementTree retornou 0 elementos em um sitemap com o namespace do sitemaps.org, e o script com namespace mostrado abaixo gravou 4 linhas a partir de um índice que listava um sitemap simples e um compactado com gzip, com & decodificado como &. O lxml 6, baseado na libxml2 como o xmllint, também retornou 0 nós para //loc e todos os URLs para //*[local-name()='loc']. Os comandos do xmllint não foram executados; eles seguem o manual. (consultada em 29 de outubro de 2026)